先找真问题
不从概念出发,从哪个环节最费人、最易错开始。
AI PRODUCT · INDUSTRIAL DEPLOYMENT
李鑫,2 年 AI 产品落地经验。把大模型接进客服、报销、录入等真实业务环节,用最少 token 跑出可量化的结果。
 LI XIN
WHAT I DO
我做的事很明确:把 AI 能力接进具体业务环节。不靠概念,靠可运行的链路、可衡量的指标、可复用的提示词。
大模型便宜了,但 token 不是免费的。我的重点是:用最少的调用次数解决最具体的问题,让 AI 真正嵌入生产流程。
看落地成果 ↓不从概念出发,从哪个环节最费人、最易错开始。
数据→模型→工作流→产出,先跑通再优化。
每次迭代看 token、耗时、准确率三项指标。
MY STANCE / 我的观点
AI 把写代码的门槛打没了,但没把「负责」两个字打没。能跑不等于能上线——AI 生成的代码进了生产,出问题不会怪到模型头上,只会怪拍板上线的人。
所以我的规矩:AI 产出的代码必须过 review,看得懂、改得动、敢维护才合并。AI 是产能放大器,不是免责声明;我拒绝 AI slop(不经甄别地堆砌 AI 生成内容),代码署我的名,责任就是我的。
代码署名是我,线上责任就是我,不往模型身上推。
每完成一个功能,换另一个 AI 交叉 review,挑完刺再合并。
每一行都要能看懂、能修改、敢维护,拒绝未经甄别的 AI slop。
SELECTED WORK / 2024—2026
AI 产品经理 · 上海快宝科技
从业务痛点梳理、POC 验证到员工培训,把智能客服、发票识别与 AI 驱动小程序推进到实际业务流程。
客服专员 · 2025
整理企业群聊数据和高频业务咨询,建立标准问答与服务规则,让客服团队更快、更稳定地解决问题。
OCR + AI · 2025
AI 分类票据 + OCR 提取固定字段,校验后自动落库,把报销录入从手工逐条填写变成拍照即入库。
市场调研 · 2025
以小版本试错和使用反馈为节奏,完成千问奶茶互助小程序、钓鱼人钓点小程序与名片识别软件的原型与测试。
PROOF OF WORK
不是只会写方案。
汽车配件全平台单月业绩
来自简历中的运营经历
投放期转化客资
小红书聚光投流项目
AI 产品落地与业务提效
复合经验
LET'S BUILD
上海 · 聚焦 AI 嵌入业务流程、降本提效类项目
02 / METHOD
这里记录我把 AI 接进业务前的拆解方法:先定义输入输出,再设计提示词和工作流,最后用最少 token 跑出稳定结果。
找到最费人、最易错的环节,明确 AI 要替代哪一步、产出什么格式。
把混乱的源数据整理成结构化输入,明确 AI 每一步要返回的字段和格式。
用 Dify 或代码编排工作流,把检索、生成、校验串成一条稳定链路。
用真实数据回测,压缩不必要的调用,在保证准确率的前提下把 token 成本压到最低。
↗四个步骤对应 AI 落地的四个关键环节,每个项目都会按这个框架拆解并记录,确保可复用、可衡量。
把业务语言翻译成 AI 要处理的输入和产出。
让数据以最低理解成本进入模型。
把检索、生成、校验串成稳定链路。
按 token、耗时、准确率三项指标迭代。
04 / SKILL LIBRARY
把跑通过、能稳定产出的提示词、工作流、操作步骤沉淀成 Skill,下次同类任务直接调用,不再从零搭。
19 个开箱即用的 Skill,覆盖文档处理、前端设计、API 接入、MCP 构建、自动化测试等场景。Agent Skills 生态的参考实现。
14 个 Skill 组成完整软件开发生命周期:brainstorming → 计划 → 实现 → 代码审查 → 验证收尾,强制 TDD 和系统化调试。
TypeScript 大师 Matt Pocock 日常使用的工程技能集,小而可组合,不做 vibe coding,覆盖 spec、triage、tdd、code-review 全链路。
社区精选的 Claude Code skills、hooks、slash commands、agent 编排器和插件清单,找 Skill 先看这里。
SKILL / COLLECTION
Anthropic 官方维护的 Agent Skills 参考实现,覆盖文档处理、前端设计、API 接入、MCP 构建等场景,是整个生态的质量基准。
SKILL / COLLECTION
14 个 Skill 组成完整软件开发生命周期,从需求澄清到代码审查到收尾验证,强制 TDD 和系统化调试,Claude Code 生态最成功的工程流水线。
systematic-debugging
4 阶段根因分析流程,整合 root-cause-tracing、defense-in-depth、condition-based-waiting。
brainstorming
苏格拉底式设计澄清,动代码前把需求问清楚,避免方向错了再返工。
writing-plans
生成清晰的实施计划,让一个没上下文、没品味的初级也能跟着做。
executing-plans
内联执行计划:单次上下文、最终一次 review,不跑偏。
subagent-driven-development
子代理驱动开发,两阶段 review(先查 spec 合规,再查代码质量),可自主跑数小时。
writing-skills
按最佳实践创建新 Skill,含测试方法论。
SKILL / COLLECTION
TypeScript 大师 Matt Pocock 日常使用的工程技能集,小而可组合,不做 vibe coding,覆盖 spec、triage、tdd、code-review 全链路。
SKILL / COLLECTION
社区精选的 Claude Code skills、hooks、slash commands、agent 编排器和插件清单。找 Skill 不知道从哪下手,先看这个导航站。
karpathy / autoresearch
Karpathy 的自主研究 agent,把 program.md 当 Skill 用。
forrestchang / andrej-karpathy-skills
行为矫正类 Skill 合集,123k stars。
alirezarezvani / claude-skills
380+ 全场景 Skill,覆盖工程、营销、合规、C-level 顾问。
以上是 awesome-claude-code 精选清单中的高分代表。完整列表(含 hooks、slash commands、agent 编排器、插件)直接去仓库查看,链接已在上方。
01 / OUTPUT
这里是已经接进业务的 AI 项目:客服、发票识别、录入提效、小程序原型。每个项目都有具体的执行链路和可量化的产出。
企微群聊清洗成 QA 语料,Dify 工作流 + RAG 实现自动应答,客服效率提升 50%。
↗类小红书社区:AI 生成界面,开源爬虫采集内容落库洗稿,多个 API 模拟用户互动完成冷启动,为社区引流到主小程序。
↗AI 分类票据 + OCR 提取固定字段,自动落库,把报销录入从手工变成结构化数据。
↗千问奶茶互助、钓点、名片识别等小程序原型,小版本试错,用真实反馈驱动迭代。
↗每个项目都按这条标准验收:链路跑通、token 成本可控、提示词和工作流可沉淀复用。
数据→模型→工作流→产出,完整跑通。
按 token、耗时、准确率三项指标调优。
对接现有系统,不做孤岛工具。
验证过的提示词和工作流固化复用。
CASE STUDY / SERVICE FLOW · 2025
把企业微信上千个群的客服对话清洗成 QA 语料,接入 Dify 工作流 + RAG,实现 AI 自动应答,客服响应效率提升 50%。
从企微群聊清洗出有效对话 → 规整为 QA 问答对 → 接入 Dify 知识库与工作流 → Agent 改写用户输入降低误判 → QA 记录系统持续自增长。核心产出:客服效率提升 50%,知识库越用越准。
转折点是 AI 的「Claude 时刻」:模型通过 API 接入终端,以 CLI 的模式在命令行里直接读写代码文件,已经能产出生产级别的代码了。
当时最火的项目是「知识库」:把公司的一些垂直经验沉淀在系统里,对新员工入职是比较好的帮助,能让他们更快上手。
有人把 AI 和知识库结合:塞一些知识进去,AI 从里面拿到相关结果来回答问题,帮员工快速入职。AI 客服的逻辑是类似的,所以这时就火起来了。
因为市场工具的成熟和一个实际热门项目的落地,促成了我们去做这款 AI 客服工具,分一个前端、一个后端。技术选型上:当时模型调用走中转站方式,避免直连海外 API,成本与可用性更可控;市场主流是 Gemini、Claude、Cursor 三家(没有 Codex);并用三模型来回循环 + 简单模型交叉验证,证明产品当时确实能落地。我本人负责 [我的角色]。
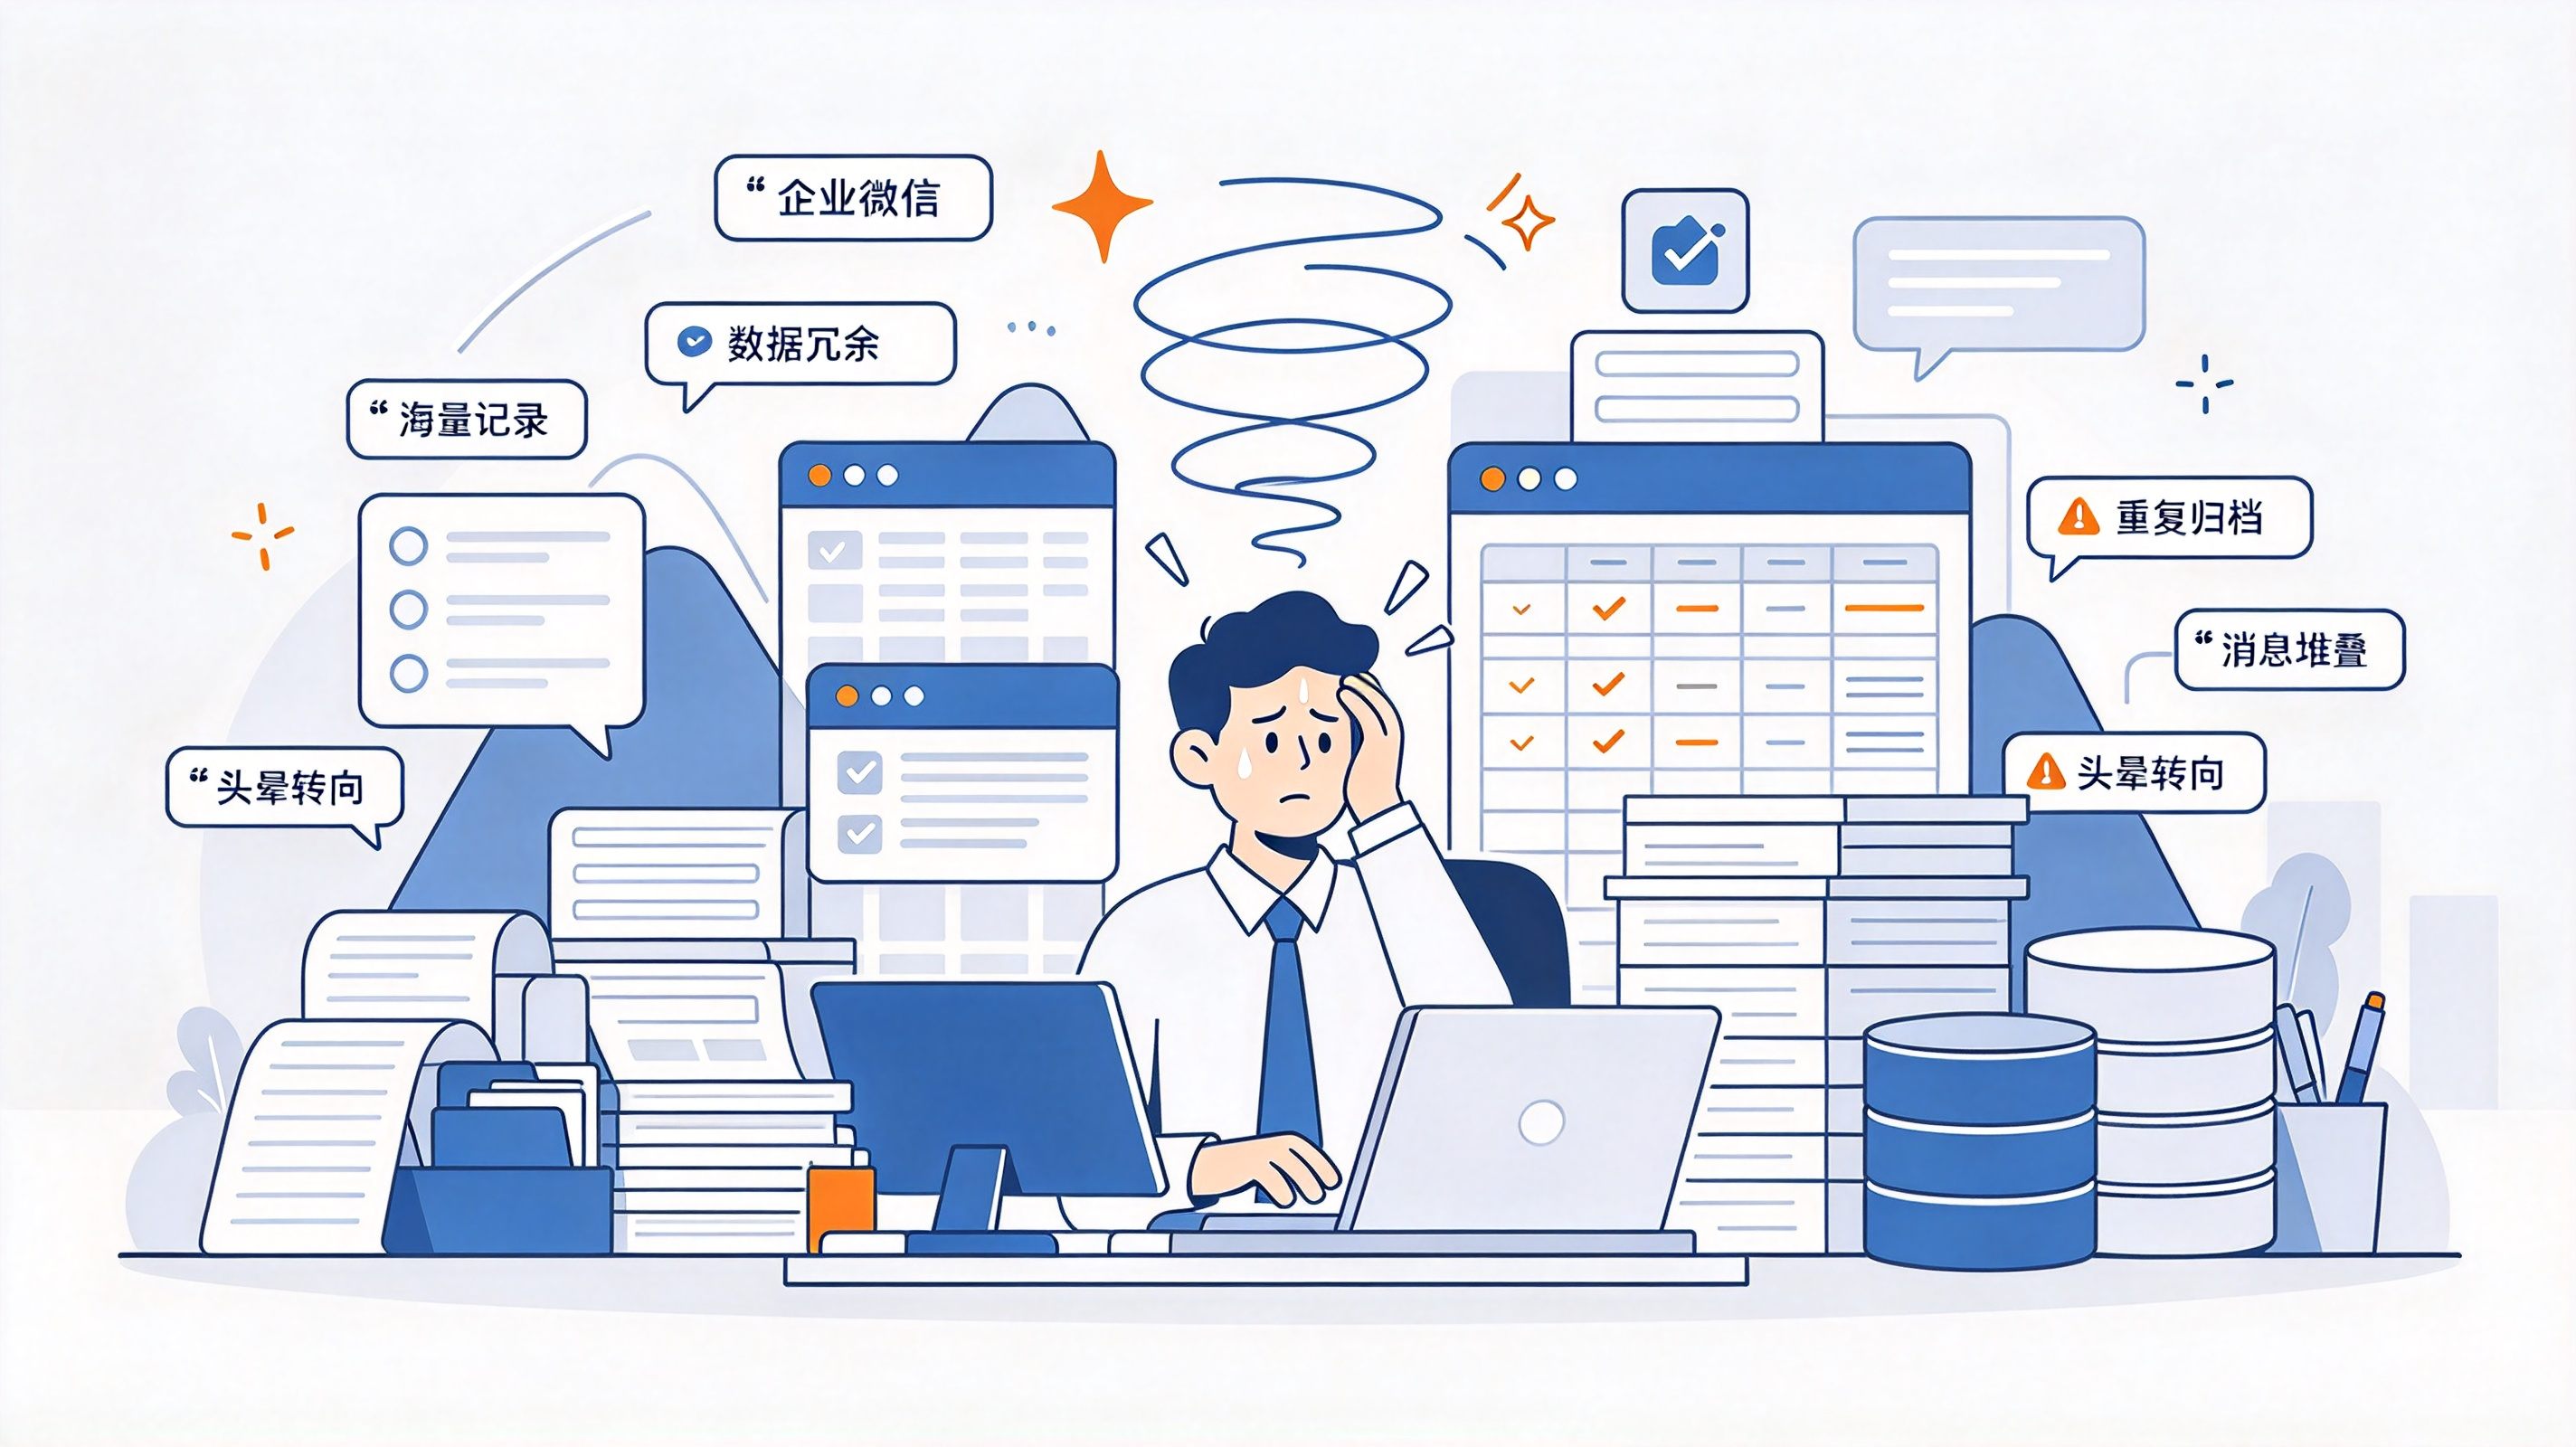
项目启动时的设想比较乐观:数据是现成的,把数据库交给 AI 识别、让 AI 产出结果,这件事就基本结束了。我们明显低估了「源数据」的复杂度——这就在一开始埋下了卡点。
真实数据远比设想复杂:企业微信里有几百甚至上千个群,聊天记录全部混在一起。要做的第一步,就是把「客服和客户之间」、且是「有效」的那部分对话挑出来。这一步直接把我们卡住了,难度远超预期。
应对方式是层层筛选:先剔除图片,再剔除语气词等噪音;最终锁定以 Uni ID 为主线,通过 Uni ID 与固定客服的对话时间段交叉对比,把单个客户和客服的对话摘出来。摘出后再用 AI 提炼,把对话转成客户可能会问的问题。
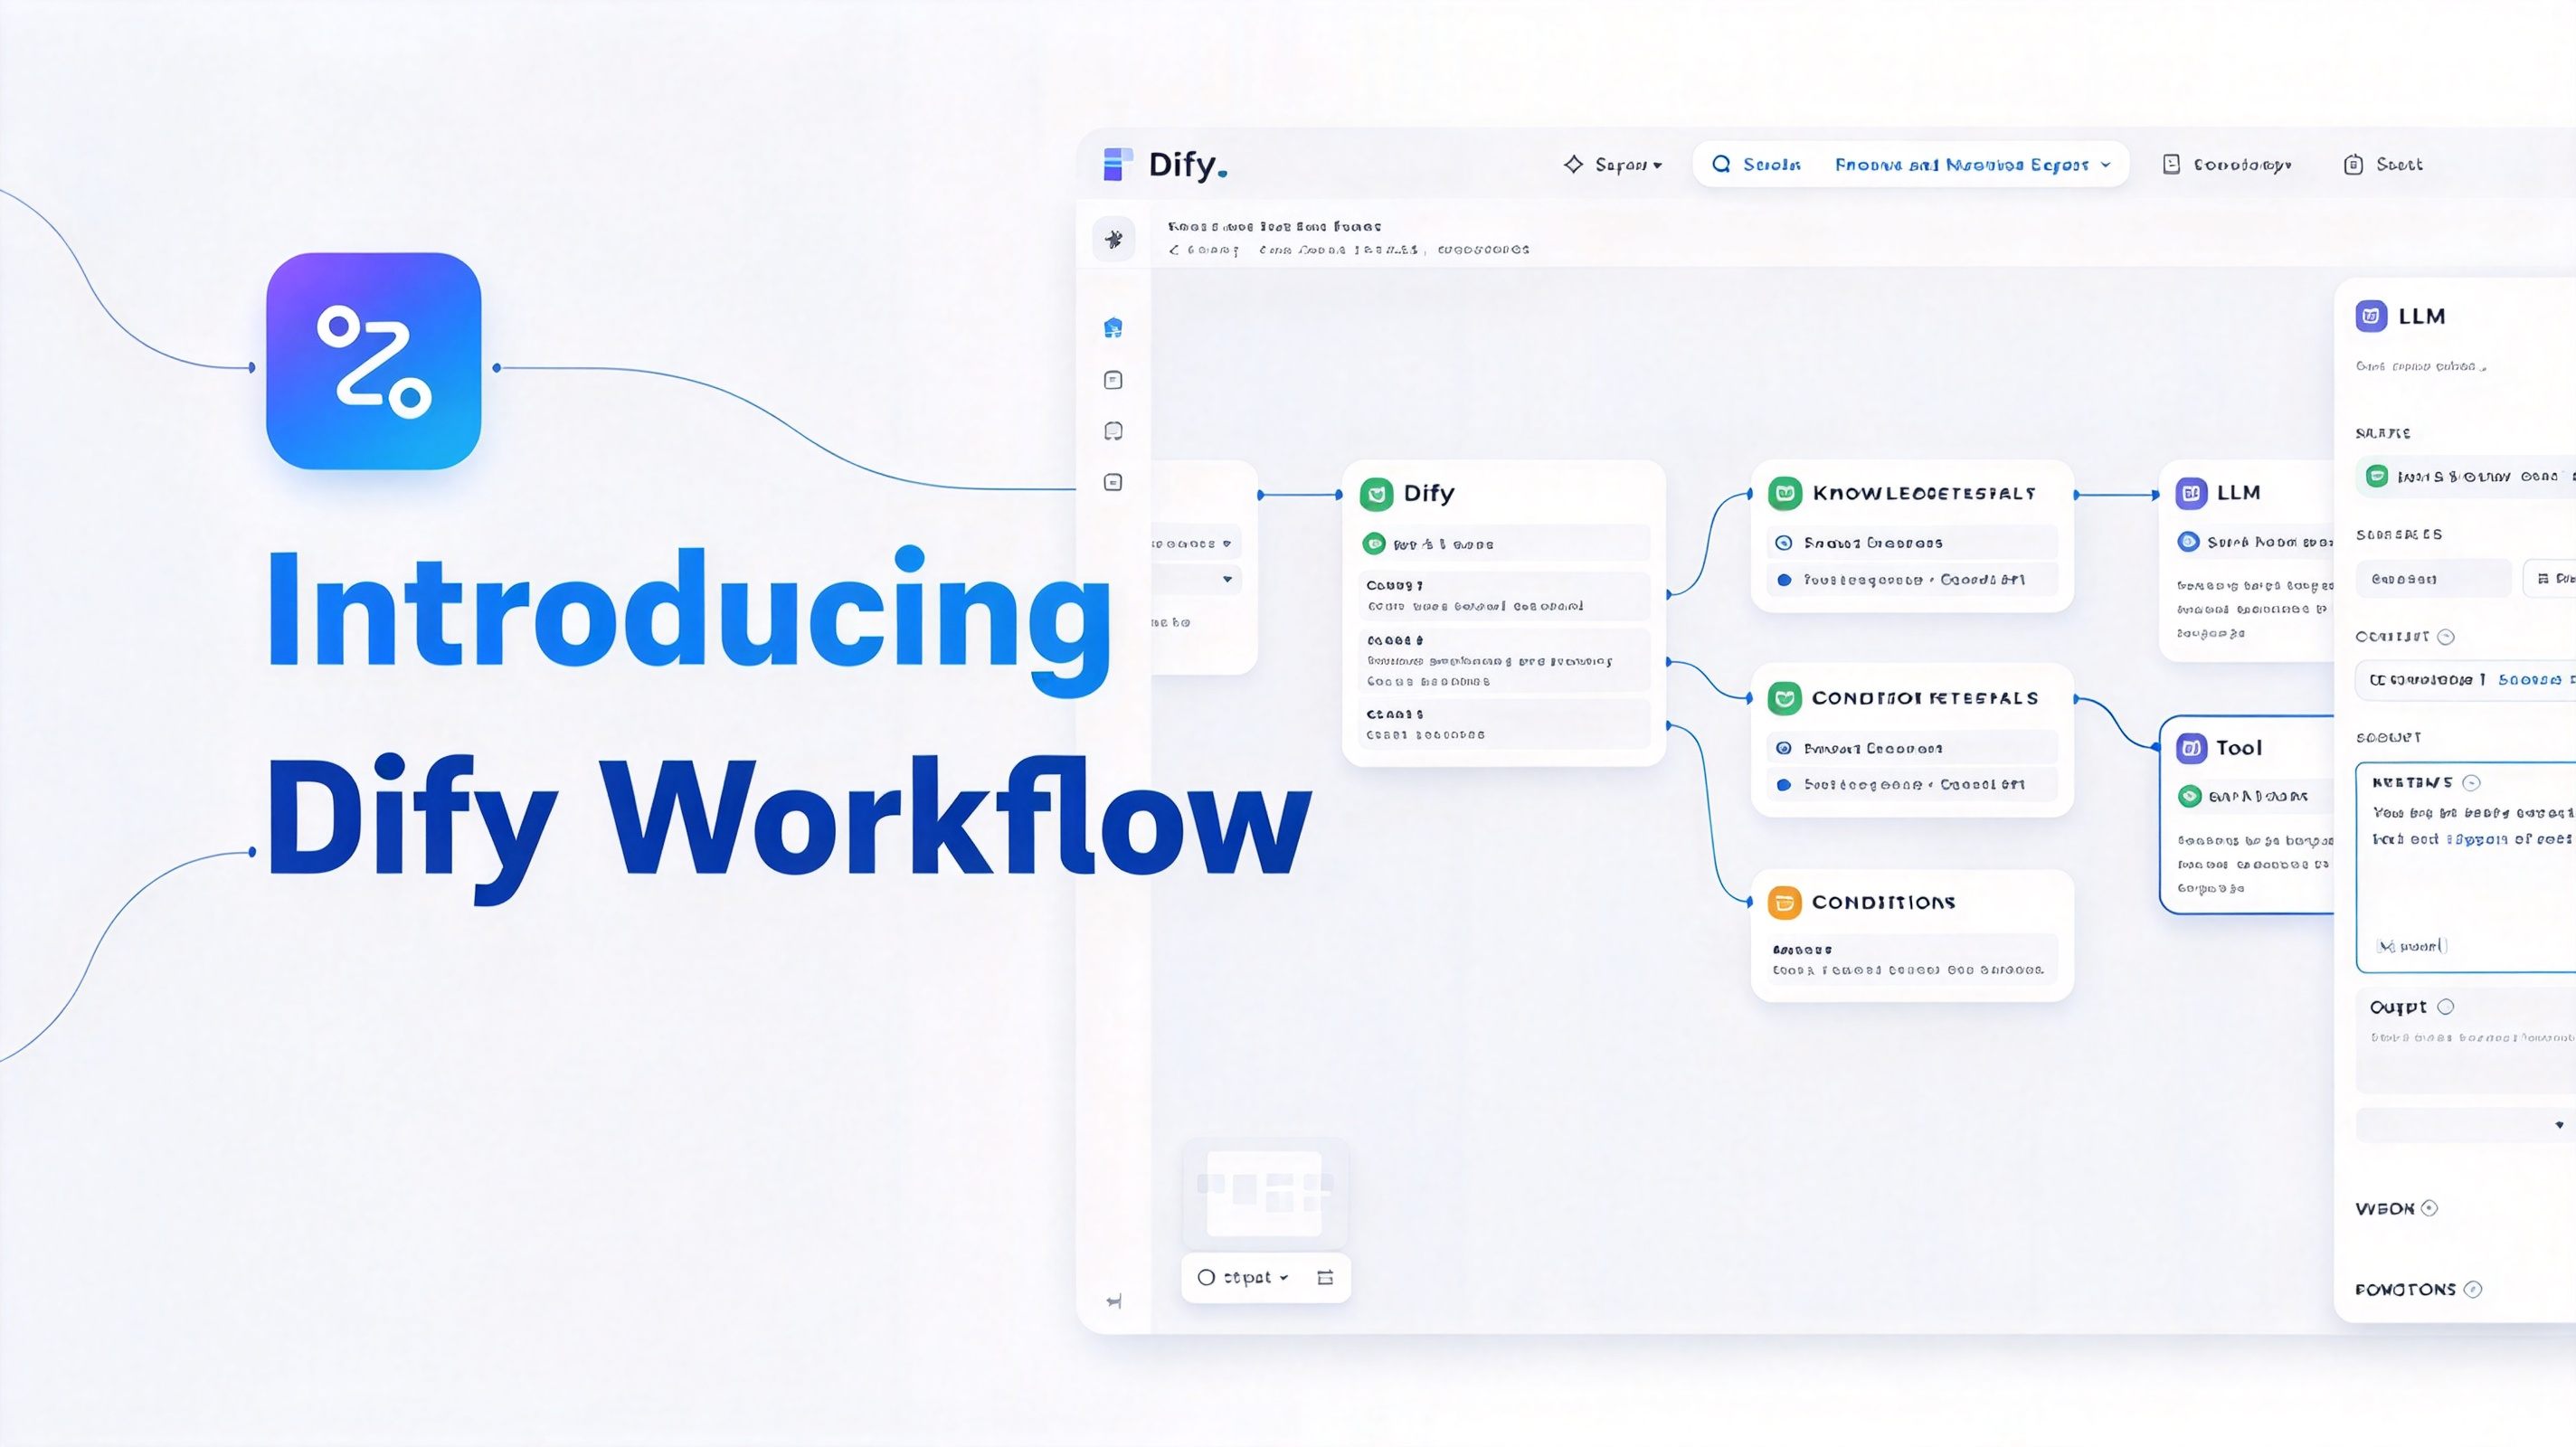
数据清洗完成后接入迪派(Dify)系统,依托其工作流引擎(Dify Workflow),将「用户提问 → 语义检索 → 答案返回」的完整链路结构化编排。
Dify 工作流内置知识库能力。我们将整理后的数据按统一格式规范为「问题—答案(QA)」问答对,并预先注入 Dify 知识库,使其可被后续环节检索复用。
借助该工作流,用户提交的对话在生成答复前先进入 AI 处理链路,而非对知识库做直接检索。
在工作流中接入大语言模型(GPT),用于判断用户表述是否与知识库内预置的问题(Q)相符,从而实现意图识别与问题定位。
确定命中的问题(Q)后,召回其对应的预置答案(A)并返回给用户——即通过检索增强生成(RAG)的方式实现智能客服应答。
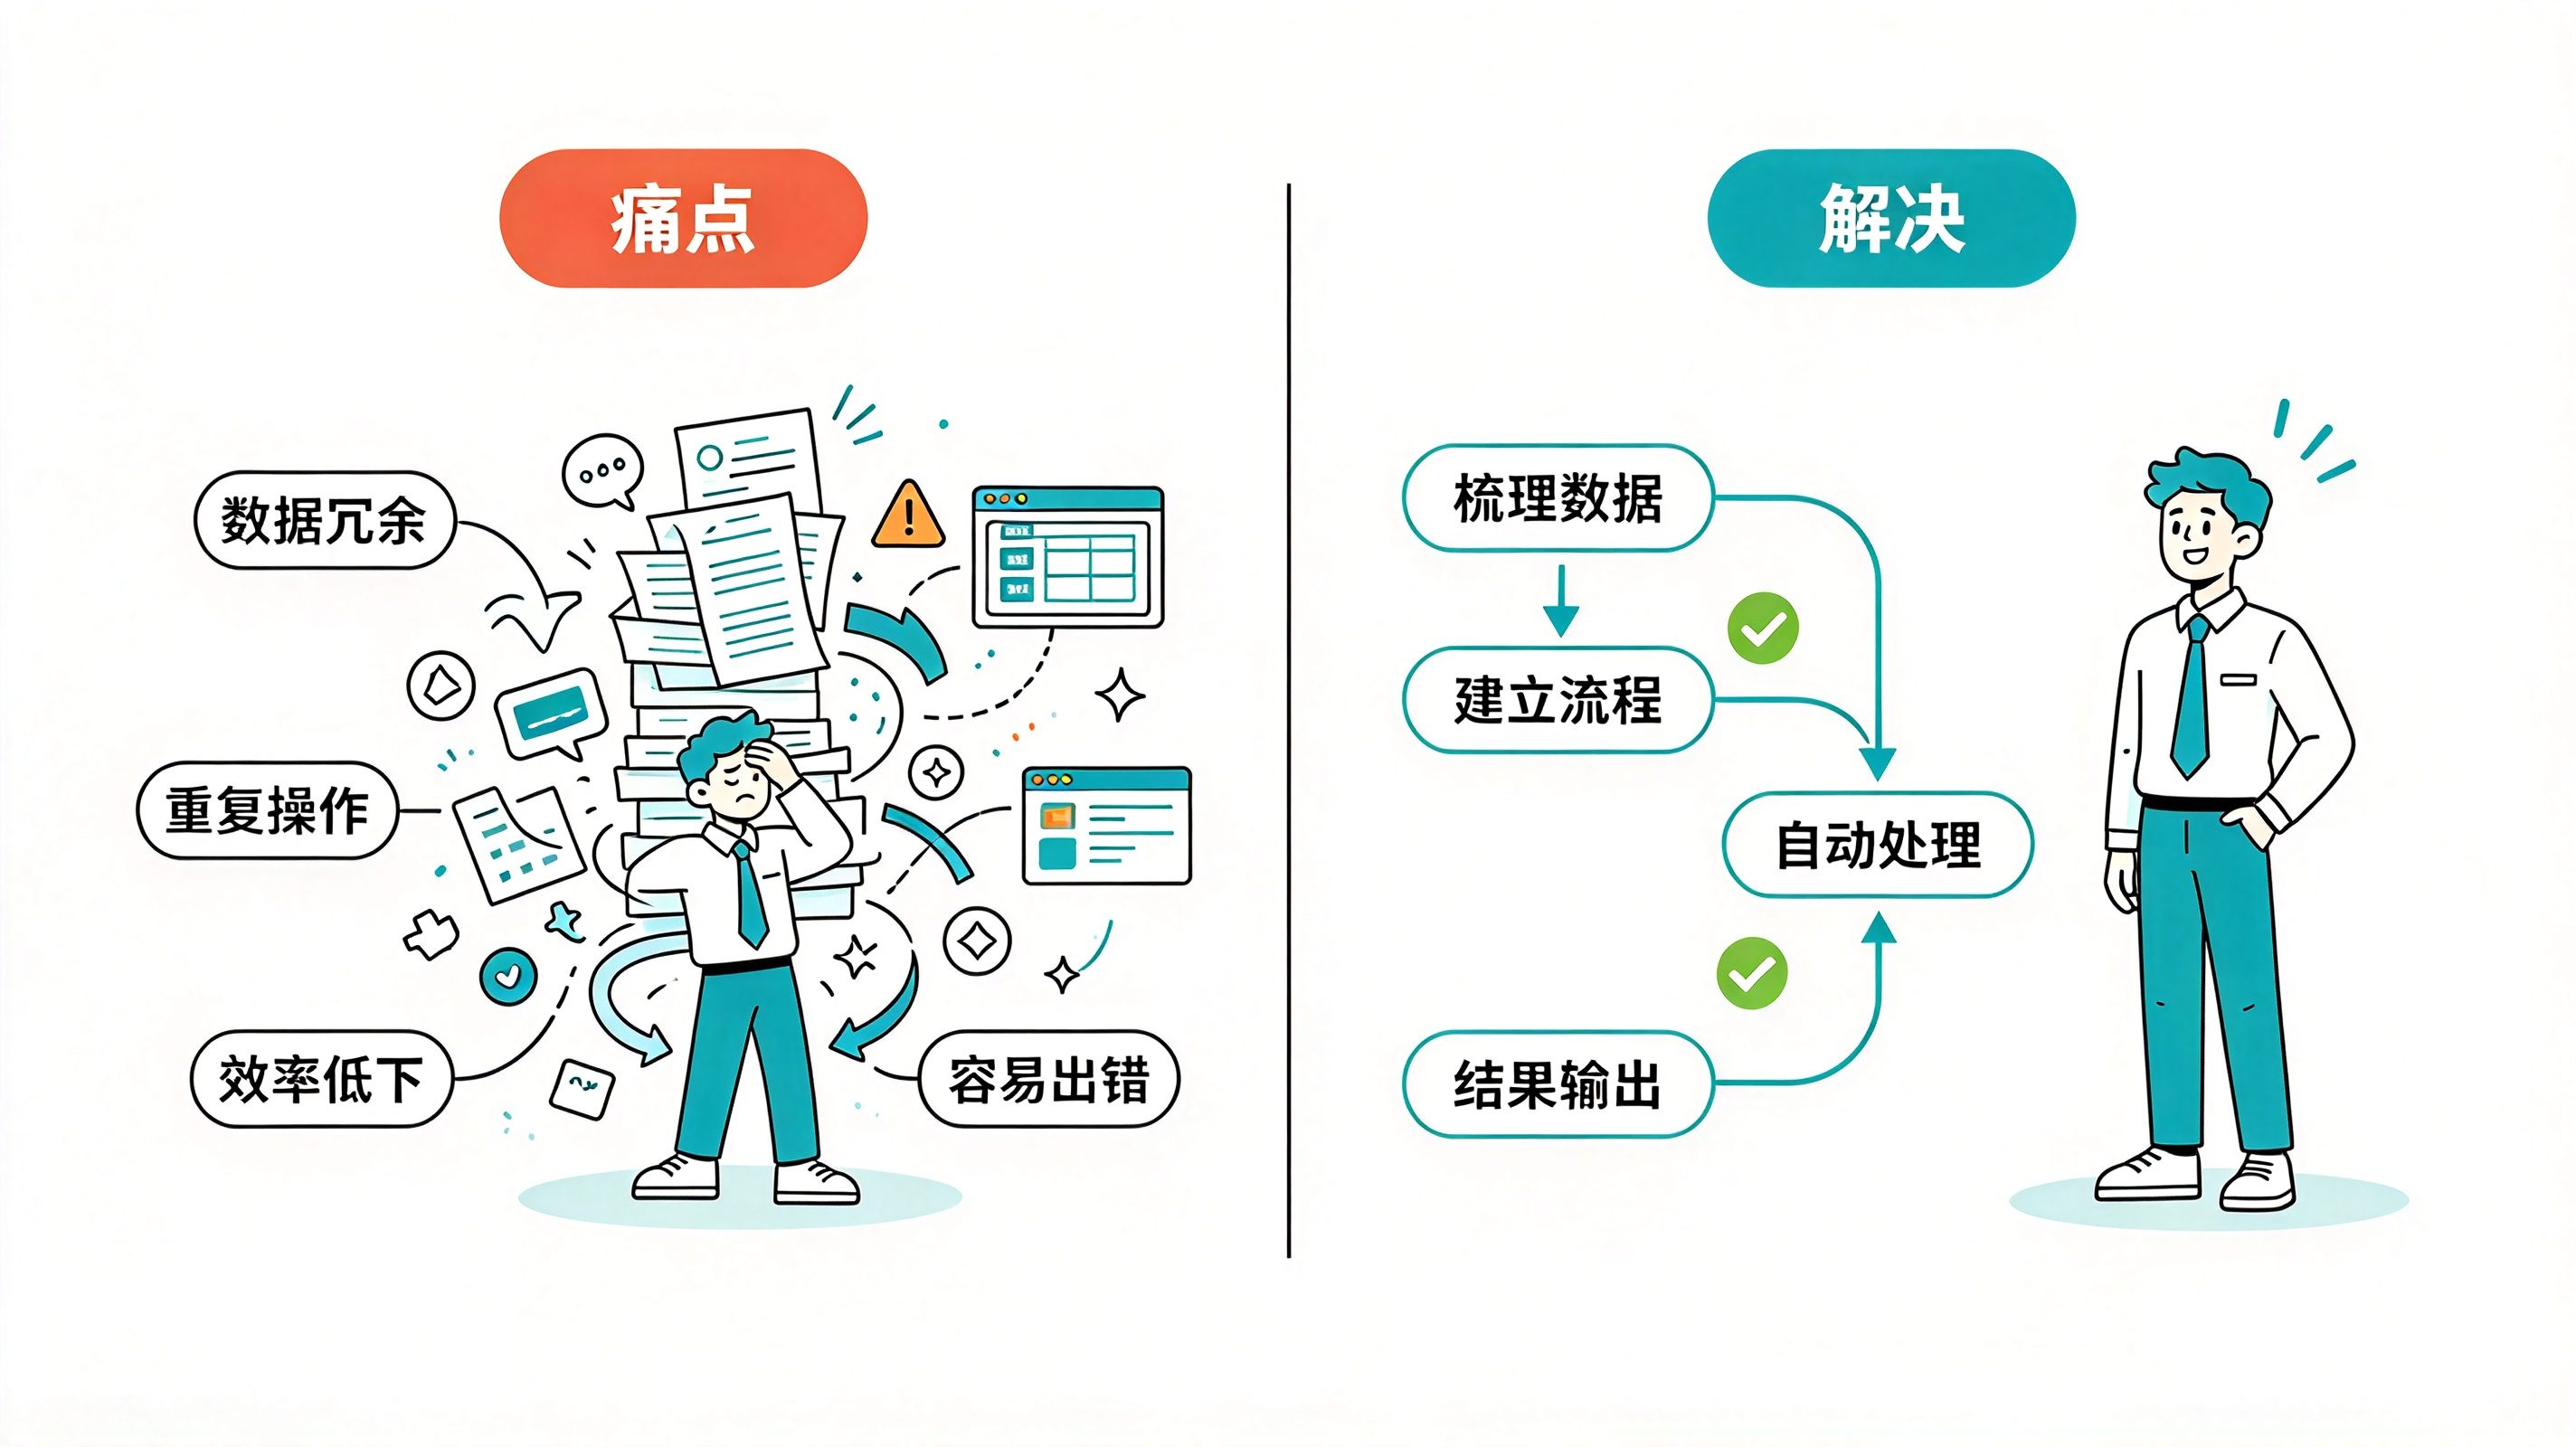
痛点:用户提问一旦被 AI 识别成另一种意图,答案就会答非所问、出现纰漏,因此项目中最复杂的一环是系统上线后的反复调优。解决:用 Agent 先识别并改写用户输入,使它与知识库「问答(QA)」保持一致表述,再进入匹配环节,从源头降低误判、保证答案一致性。
痛点:用户的真实表述很难每次都精确命中知识库预置的问题(Q),语义一旦偏移,错误召回就直接影响客服质量。解决:预先将语料规整成「问题—答案(QA)」问答对存入知识库,通过检索增强(RAG)召回最接近的问题并返回对应答案,以结构化方式收敛歧义。
痛点:当用户问出知识库未覆盖的问题时会漏答;若随意补充新的问答,又难以保证入库质量。解决:配套搭建「QA 记录系统」,未命中问题由客服记录入库,并设专人识别与鉴别,确认该问答准确、合适后才允许回灌,形成越用越准的知识库自增长闭环。
CASE STUDY / AI COMMUNITY · PRIVATE TRAFFIC
做一个对周边居民真正有用的社区助手小程序,把水电燃气、快递站、公共设施等信息做成「社区白皮书」,把社区用户沉淀进私域,再导向公司主小程序。
公司想借 AI 快速产出一个项目。我的切入点是社区引流:用一个有用的社区助手把周边居民聚起来,再往公司主小程序导流。前端用 AI 快速生成类小红书的帖子社区,后端用开源爬虫采集小红书内容、落库后 AI 洗稿,最后接入多个 API 模拟 AI 用户互相评论聊天,完成社区冷启动。
立项动机很直接:大模型能力成熟了,公司希望用 AI 快速做出一个项目,而不是按传统节奏慢慢开发,所以整个方案从一开始就围绕「AI 能替我们干什么」来设计。
根据当时的业务情况,我判断机会在社区:做一个社区入口把周边居民聚起来,再把这批用户引流到公司主要的小程序里。核心不是做流量平台,而是做私域获客,把人沉淀到自己的池子里。
要让居民愿意来,工具本身得有用。小程序定位为社区助手:周边居民可以快速查到水电燃气信息、周边设施、快递站、公共设施、社区位置等真正有价值的信息,相当于一本随用随查的社区白皮书,先有用,再谈导流。
先定形态:不是电脑端论坛那种板块列表,而是手机端一条一条往下刷的帖子流,用户单手就能浏览,参考的是小红书这类社区的信息流样式。形态定好之后,界面没有从零手写,而是让 AI 直接生成整套前端,先把一个真实社区的壳快速搭出来。
空社区没人来,冷启动先得有内容。做法是找 GitHub 上的开源爬虫项目,把小红书上的帖子数据采集下来,通过接口先存进自己的数据库;落库之后再用 AI 对文章洗稿改写,变成自己社区里的帖子,解决「社区里没有内容」的第一道坎。
真实用户不会进一个空社区,所以先解决「人从哪来」。我创建了几十个规定角色的提示词,接入多个 AI,每个 AI 都对应一个角色形象;再把帖子内容和已经发送的聊天上下文一起作为上下文输入给它们,AI 就能顺着帖子和上文接话、把对话串联起来,自己跟自己交流。这样真实用户进来时,看到的就是一个有人发帖、有人讨论的活跃社区。
先解决数据源:在 GitHub 上找开源采集项目,按它的教程配置运行,成功把小红书的帖子数据采集下来并存进自己的数据库,这一步打通后,库里就有了原始的文章内容。
接着把数据库接进工作流:工作流逐条读取库里的某个字段(比如文章字段),在统一的洗稿规范下调用 AI 改写,输出符合社区风格的新内容,再把洗稿结果写回数据库。原始数据经过这一步,就变成了可以直接发布的自有帖子。
内容备好后开始造社区氛围:先用模拟用户把洗好的帖子一条一条发布出去,再接入 API,让其他带角色的 AI 针对每条帖子进行回复互动。发帖和回复跑通后,一个有内容、有人互动的社区就搭起来了,达成了冷启动的目标。
采集来的内容质量参差不齐,有些帖子洗过稿之后仍然不适合发布。为此单独写了一个过滤脚本,在发布前对数据做一轮筛查,把不符合要求的内容排掉,只让合格的帖子进入发布环节。
爬下来的内容里会夹带一些敏感信息,原样发布有合规风险。处理方式是把脱敏作为工作流的固定一环,识别并抹掉不必要的敏感信息后,再写入数据库、进入后续发布。
如果同样的内容持续发布、用户乱发一通,真实用户很快会怀疑社区里机器人占比过高。做法是给每个模拟用户设定自有的行为逻辑,让发帖有合理的节奏和间隔、内容不重复,尽量贴近真实居民的使用习惯,降低机器感。
这些问题不是零散处理的,而是做成了一整条脚本工作流:帖子从采集下来开始,依次经过洗稿、落库、合规判断、剔除无效与敏感信息、脱敏,最后按拟真逻辑控制发布,每一步由脚本自动衔接,逐步实现从原始数据到社区真实内容的转化。
CASE STUDY / RAPID PROTOTYPE · 2025
钓鱼分享、千问奶茶互助、跨境电商 Shopify 独立站三条线并行,HTML 原型先行、模块化复用,用同一套 AI 生产流程快速产出。
整条 AI 生产流程跑通之后,开始多方向快速产出:钓鱼分享、千问奶茶互助、跨境电商 Shopify 独立站三条线并行。统一打法是 HTML 原型先行、跑通再进小程序,配合模块化组件复用控制成本。核心产出:三个可运行项目,其中独立站已是正式变现方向。
在做这批项目之前,前一个项目已经完整走通了一遍:从需求文档开始,到 AI 生成前端、后端,再到接口联调,最终上线。整条用 AI 做生产的链路被验证可行,团队对每一步怎么配合、怎么衔接都有了实际经验。
单点跑通之后,关注点从「能不能做成」变成「能不能批量做」。既然一条完整的 AI 生产流程已经在手,就想试着用同一套方法,在更短时间里同时推进多个方向,验证这套生产方式的复用能力和产出效率。
当时定了三个方向:钓鱼分享小程序、奶茶互动小程序,以及跨境电商的 Shopify 独立站。三个方向场景各不相同,但都用已经跑通的 AI 生产流程来做,用实际产出检验这套流程能不能支撑多方向、快速的项目交付。
这个方向是根据自己的钓鱼爱好做的,目的是帮钓友之间互相分享。小程序里整合了潮汐、天气、路线等信息,钓友每到一个地方,打开小程序就能查到附近哪里好钓,把「去哪钓」这件事变简单。
这是当时的一个快速创新项目。奶茶活动上线后,用户参与互助就能拿到更多奶茶,但前提是要把活动分享出去。于是做了这个小程序,让大家互相助力——你推荐我、我推荐你,通过裂变帮用户拿到更多千味奶茶。
独立站是跨境电商里很重要的一环,国外也一直有建站需求。思路是用 AI 快速产出代码,完成独立站的铺设,把建站这件原本耗时的事压缩。和前两个偏尝试的方向不同,这一条当时已经按正式变现方向来做。
每个项目开工前,先把整体内容、业务逻辑和页面的构成方式想清楚,然后直接在需求文档里产出 HTML,用它充当高保真原型图。HTML 原型能直接打开看效果、改起来快,比静态设计稿更贴近真实产品。
HTML 原型先在浏览器里跑通,确认页面结构和交互没问题之后,再把它移植到小程序里。这样到小程序阶段就不是「边做边想」,而是把已经验证过的东西搬进去。
每做完一个部分(比如一个界面,或一个比较完整的功能),就做一次代码 review:让另一个 AI 来审我们自己 AI 产出的代码,专门挑这个代码的刺,再根据 review 结果对代码进行修复或调优。相当于用 AI 交叉检查代码质量,问题在过程中就被消化掉。
产出里相通的部分都做模块化:按钮、表单、通用组件等尽量不重复写同样的东西,一次做好、到处复用。多个项目并行推进时,这套组件积累让每个新项目的开发量越来越小。
项目规模小的时候,AI 生产很顺;但做到中期、中后期,上下文会越积越大,token 消耗量随之增加,问题就开始集中出现。这是多项目并行快速产出时最核心的痛点。
解决方式是拆分项目:把项目拆分成一块一块的,尽量对某一块单独进行调整,而不是整体去动上下文。块与块之间边界清晰,单次改动小、可控,出了问题也容易定位。
这条经验反推到最前面:写需求文档的时候,就要保证以块状逻辑去安排整个生产节奏。不然等项目推进到后面、代码欠账太多之后,就会出现比较难修复的问题。
CASE STUDY / DOCUMENT FLOW · AI ASSISTED
AI 分类票据类型 + OCR 提取固定字段,自动落库,把出差报销的手工录入变成结构化数据流。
团队频繁出差,一次带回 10–20 张发票需手工录入。方案:AI 先识别票据类型,再按类型用 OCR 提取固定字段,校验通过后自动入库。核心产出:报销录入从逐张手填变为上传即入库,大幅压缩人工。
团队里有很多人需要频繁出差,出差期间会积累较多票据;一次出差通常会产生 10 到 20 张发票,这些票据都需要进入报销流程。
如果把发票一张张上传并填写,会非常浪费时间。所以立项目标很直接:看看能不能直接识别发票,通过快速上传图片、一次性完成发票信息识别,把报销从手工录入中解放出来。
大家上传的票据有一部分是高度相似的:同一类型的发票,字段基本固定。比如高速通行费发票,无非是发票代码/号码、车牌号、通行时间、入口/出口收费站、通行费金额这些固定字段;火车票也很固定,就是始发地、目的地、车次、乘车日期、座别、票价。这给「按类型建库、稳定提取」留下了空间。
处理链路分两步:第一步,先用 AI 识别这张票据属于哪一类(高速、火车票等);第二步,基于识别到的类型,用 OCR 图片识别方式把内部的字段数据提取出来。这样就不用从头猜每张票的格式,提取准确率更高。
识别出类型后,就能在数据库里把这类发票的字段列好、固定下来;每一张上传的票据都按对应的字段结构入库,从而稳定统一地归集,为后续报销和归档打好基础。
第一步先把各类票据的字段列出来。火车票/高铁票:乘车人、证件号、车次、乘车日期、始发地、目的地、座别、票价等;出租车票(出租汽车客运发票):发票号码、起止时间、里程、单价、金额、车牌号;公交票则相对简单,主要是线路、日期、票价。字段先固定下来,后续提取才有据可依。
流程串联为:先用 AI 识别这张图属于哪类票据;再按类型用 OCR 把票面字段数据识别出来;随后进入数据判断环节做规则校验(必填字段、格式、金额合理性等);判断通过后落库。每一张发票传进来都能得到一条结构化数据并稳定写入数据库。
数据落库后,再交由 AI 做一轮分析,确认这条信息属于什么类型、对应哪一次差旅行程,为后续的统一统计和报销归档提供更可读的语义。
预置的票据类型有限,遇到模板外的票据时提取会缺字段。做法是:未命中类型的票据先走通用 OCR 拿到全文,再由 AI 按关键字段补全,最后人工确认后入库,既不漏数据又不牺牲准确率。